

 Member
Alexandre
MemberForum Replies Created
Et celles et ceux qui sont en situation de handicap ? 🙂
Ben oui ceux là ne peuvent pas utiliser la signature. Alors comment font t’ils ? 😉
Alexandre
Member27 novembre 2025 at 8h17 en réponse à: Utiliser du texte enrichi pour insérer des données dans un template wordBonjour
Si ton template est peuplé depuis power automate, alors je me souviens qu’il y a un truc, soit les champs ne sont pas du tout détectés et proposés dans l’action power automate, soit si tu as de la chance elle est proposée mais c’est un libellé numérique, dont tu ne sais pas trop à quel champs il peut correspondre (je ne sais plus quel est le cas)
Donc je pense que parmis ces 2 options c’est la première, c’est à dire tu ne peux pas utiliser de champs texte enrichi dans ton template, uniquement des champs texte brut, des répéteurs et de mémoire de la doc, des champs date.
Là comme ca je n’ai pas de solution à te proposer, à part peut être creuser la piste du graphAPI pour voir si tu peux t’en sortir avecSalut à tous
Pour clôturer mon besoin, et suite à l’ouverture d’un ticket chez MS, il se trouve que malgré que la doc indique qu’il est possible d’utiliser l’action SendBulkMail avec une requête FetchXML, sachez qu’il n’en est rien, le code source de l’action ne prévoit rien d’autre qu’une requête en direct query.
Voici ma requête de type QueryExpression qui passe dans power automate (pas d’erreur d’exécution) mais qui ne créé pas d’activité non plus (faut que je creuse aussi quand même pour savoir pourquoi je ne génère pas d’activité avec ca)
<pre class=”language-plaintext”>
{

"@@odata.type": "Microsoft.Dynamics.CRM.QueryExpression",

"EntityName": "not_agent",

"ColumnSet": {

"Columns": ["not_agentid","not_email"]

},

"TopCount": 50,

"Criteria": {

"FilterOperator": "And",

"Conditions": [

{

"AttributeName": "not_matricule",

"Operator": "BeginsWith",

"Values": ["123456"]

}

]

}

}
Concernant le FetchXML je me fais peut être des noeuds au cerveau pour rien car si j’en crois ce qui est écrit ici et si je comprend bien ( https://markcarrington.dev/2021/04/21/querying-virtual-entities/ ) le fetchXML serait converti en QueryExpression et donc si le fetch inclu une linked entity j’aurais une erreur :/
Voici ma requête de type QueryExpression qui passe dans power automate (pas d’erreur d’exécution) mais qui ne créé pas d’activité non plus (faut que je creuse aussi quand même pour savoir pourquoi je ne génère pas d’activité avec ca)
<pre class=”language-plaintext”>
{

"@@odata.type": "Microsoft.Dynamics.CRM.QueryExpression",

"EntityName": "not_agent",

"ColumnSet": {

"Columns": ["not_agentid","not_email"]

},

"TopCount": 50,

"Criteria": {

"FilterOperator": "And",

"Conditions": [

{

"AttributeName": "not_matricule",

"Operator": "BeginsWith",

"Values": ["123456"]

}

]

}

}Merci David,
En espérant pouvoir le faire fonctionner, si tel est le cas, je ne manquerais pas de faire un retour 😉
Et oui si vous connaissez des experts Dynamics je veux bien un petit ping pour tenter d’y voir plus clair.
Oui ma table est bien activée pour les activités (je ne vois pas vraiment ce que cela change ceci dit, mais peu importe c’est peut être pour le fonctionnement en interne)
Le JSON que tu mentionnes je l’ai utilisé pour tester l’action basique d’envoi d’un mail. Et ca fonctionne et oui lui aussi il ne s’invente pas, heureusement que d’autres devs partagent leurs connaissances 👏.
Seulement, cette action ne me convient pas car le cas d’usage est de pouvoir envoyer plus de 100k emails et j’ai très peur d’une part de me heurter aux limites du nombre d’actions exécutés par 24heures si je fais des boucles d’envoi, et d’autres part cela représente une complexité pour pouvoir suivre quels sont les éléments de ma table qui ont été traités pour l’envoi du mail.Dans le cas spécifique du SendBulkMail – et de ma compréhension – cette action est faite pour envoyer un mail selon un template, à tous les éléments de ma table qui répondent à une requête donnée. En gros, si j’arrive à le faire fonctionner, je serais en mesure de faire un flux de quelques actions power automate seulement pour préparer quelques milliers d’activités d’un seul coup. Gain d’action, simplicité du flux, facilité de maintenance…
Pour être plus précit sur ce qui me bloque aujourd’hui, c’est la QueryBase. J’ai trouvé à grand coups de questions à plusieurs IA (oui j’ai flirté avec des tonnes d’hallucinations mais j’étais prêt à tout et j’ai eut quelques réussites quand même) à trouver une structure pour le QueryBase, mais seule la structure avec une Query fonctionne, là où je bloque c’est sur l’autre possibilité : une FetchXML query.
Pourquoi je souhaite une fetchXML query plutôt qu’une Query : Le fetchXML est bien plus simple à écrire, et surtout, il permet de faire des requêtes avec des jointures là où le Query ne le permet pas.
Donc si jamais je n’arrive à rien, je tenterais en amont d’alimenter ma table avec tous les champs dont j’ai besoin pour le template mail, de manière à ne pas avoir besoin de fetchXML, mais là encore j’aurais du travail en plus pour des flux qui alimenteront cette table.
Donc pour résumer, le but de mes recherches aujourd’hui c’est vraiment l’usage de FetchXMLQuery pour cet envoi bulk email. Voici mon action. Le FetchQuery est une simple requête FetchXML stocké dans une variable
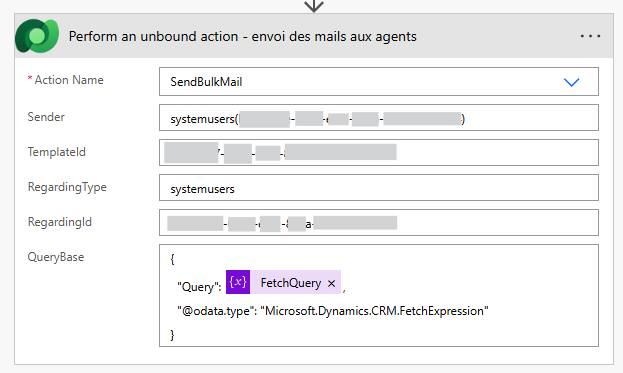
Je n’ai pas l’exemple avec une Query et qui fonctionnait car je ne suis pas sur mon PC pro, mais je le repartagerais si besoin
ah ah désolé David Nelson 😉
Je vais continuer à remonter les anos mais c’est fatiguant quand même 🙂
Mais c’est énorme !
Moi je n’arrive pas à prendre le temps. C’est hyper chronophage d’ouvrir et de suivre des tickets et la plupart du temps ca se remet à fonctionner aléatoirement sans retour.En tous cas Chapeau !
Et merci David pour ce retour sur les Checkbox. Faire un retour en déconseillant d’utiliser les contrôles modernes alors qu’ils nous poussent à ca c’est assez dingue…Bien joué @DavidZed !
Si le composant utilise des formules sur le width et height, ils sont potentiellement en valeur décimal, et quand on a une culture Francaise, ca signifie la virgule comme séparateur décimal là où le html et le css et le svg… ne connaissent que le . comme séprateur décimal (notation anglosaxone).
L’astuce de David c’est de formater ta hauteur et ta largeur en forçant la notation anglosaxone.
Pour préciser ce n’est pas recommandé car ca contraint powerapps de maintenir en mémoire les écrans qui portent les contrôles lu par d’autres écrans. Donc plus tu fais ca plus tu réduits les perfs. Sans compter que c’est toujours une mauvaise pratique de créer des dépendances entre les choses. Il faut réduire le couplage au maximum et donc le mieux d’après moi est de faire comme Redkap a dit, de passer des paramètres entre les écrans.
Et pour la manière dont powerapps optimise les chargements, j’ai constaté il y a quelques semaines lors d’une analyse intensive des chargements de mon apps pour débugger un PCF, que powerapps anticipait les chargements des contrôles sur les écrans ciblés par des navigates. En gros, si dès le premier écran powerapps constate qu’il y a un bouton avec un navigate, sans même que l’utilisateur ne clic sur le bouton, powerapps commence le préchargement des contrôles pour accélérer la navigation.
Je serais toi je tenterais un force refresh (maj+F5 ou ctrl+F5) dans un premier temps.
A une époque j’ai eut des svg dont certains effets d’animation ne fonctionnaient pas.
Tu peux aussi afficher la version de chrome sur l’apps de manière à incriminer ou pas la version du navigateur
attention @R3dKap :
Body1_10.Text in "Évo,Arv,Dpt"
Si Body1_10.Text contient par exemple “o,Ar” alors ton ‘in’ retournera vrai. Il est préférable d’écrire
Body1_10.Text in ["Évo";"Arv";"Dpt"]
Et pour le switch(true;…) c’est cocasse mais ca fonctionne aussi 🙂 le premier paramètre est une valeur (ici la valeur booleenne ‘true’) et la première condition qui est égale à ce paramètre sera considéré. Il m’arrive de l’utiliser selon mon humeur 🙂
Alexandre
Member23 avril 2025 at 7h35 en réponse à: Problème d’update de données volumineuses (200k+ lignes) dans DataversePour maximiser les chances du dataflow il y a d’abord l’elaboration d’un contrat d’interface entre le producteur des données (celui qui constitue le fichier) et le consommateur (ton datafloW) : il s’agit de décrire l’attendu en terme de colonnes, de types de données, de format de fichier etc… Il ne faut pas que le producteur modifie le contenu et le consommateur sait alors ce qu’il doit respecter et donc les étapes de traitement à réaliser dans les queries. Il faut aussi définir ce que représentent les données (mises a jour ou “annule et remplace”)
Ensuite il faut surveiller la bonne exécution de ton dataflow. Plusieurs critères entrent en compte : fréquence de mise à jour, durée d’exécution, est-ce que plusieurs tables sont mises a jour avec le même dataflow etc… Soit tu le fais toi dans le cadre d’un maintien en situation opérationnelle. Soit c’est une autre structure. Il faut que les dataflow soient tous avec un compte spécifique (le owner du dataflow) car seul le propriétaire peut avoir accès à ses dataflows. Autre possibilité, tu fais une ihm ou un powerbi qui va recuperer les historiques d’exécution dans les tables ‘dataflow’ et ‘refreshEntityHistory’. C’est loin d’être simple car non documenté ça peut donc être modifié n’importe quand par Microsoft etc… Mais ça fonctionne
Alexandre
Member22 avril 2025 at 20h36 en réponse à: Problème d’update de données volumineuses (200k+ lignes) dans DataverseHello,
Effectivement de mon côté j’industrialise mes imports massifs de données via des dataflows. Mon scénario est le suivant :
1/ dépot d’un fichier référentiel par un tiers sur une biblio sharepoint
2/ détection du dépôt via power automate puis archivage du fichier dans un répertoire de travail et lancement de l’exécution du DF
3/ le power query de mon DF est configuré pour récupérer le fichier sur le chemin attendu avec le nom attendu, il procède à l’insertion (en mode update ou non) dans mes tables Dataverse
4/ (ou 2/ bonus) j’utilise le trigger de fin de chargement de dataflow dans le même flux pour (on peut effectivement utiliser le déclencheur en plein milieu du flux) afin de faire mes posts traitements si besoin (nettoyage de fichier, logs d’exécution etc…). Cela peut aussi être réalisé dans un autre flux à part entière.
Le plus gros inconvénient pour les dataflows est l’ALM. A chaque livraison de ces dataflows sur un nouvel environnement tu devras les reconfigurer pour qu’ils utilisent les bonnes sources (pour configurer des sharepoints différents selon tes environnements)
-
This reply was modified 1 year, 7 months ago by Alexandre. Reason: précision sur les inconvénients des dataflows
-
This reply was modified 1 year, 7 months ago by
Alexandre
Member15 avril 2025 at 19h12 en réponse à: Questionnement autour du déploiement de solutionMy bad ! Je ne bosse qu’avec du Dataverse :/ Du coup on peut oublier les divisions.
Tu peux créer des variables d’environnement ou pas ? Si oui alors tu configures les sites SP pour les différents départements. Il ne te restera alors qu’à prendre le bon site sharepoint selon le département de l’utilisateur.
NB : bien évidemment cette solution est loin d’être sécurisée. Il faudra être vigilent sur la sécurisation de tes sites sharepoints pour t’assurer que les utilisateurs du site A ne puissenr pas avoir accès aux listes du site B
-
This reply was modified 1 year, 7 months ago by Alexandre.
-
This reply was modified 1 year, 7 months ago by