
 Member
ypicot
MemberForum Replies Created
Bonjour
Il est effectivement nécessaire que tes utilisateurs disposent d’une licence Pro pour accèder aux rapports, même en consultation seule.
Deux alternatives (plus ou moins intéressantes) :
- Si tu as un Power BI Premium, tes utilisateurs peuvent se connecter sans avoir de licence Pro. Cependant, il est nécessaire d’avoir un espace Premium pour cela, et le ticket d’entrée est de l’ordre de 5000€/mois (donc intéressant si tu as beaucoup d’utilisateurs)
- Tu peux également utiliser une publication web. Attention, l’accès se fera sans aucune authentification, ce qui signifie que toute personne ayant l’URL pourra accèder au rapport. Sécurité zéro.
Yvan
Bonjour
Je n’ai pas (encore ?) été confronté au problème du “.”, mais à celui de l’espace.
Seule solution que j’ai trouvée : un bon vieux remplacement de l’espace par du vide ☹
Si c’est aléatoire (dépendant du poste), tu peux envisager de créer une fonction M qui converti tout au format de ton choix et qui retourne le résultat en nombre à virgule. Mais je reconnais que ce n’est pas hyper clean.
ypicot
Member2 septembre 2025 at 10h25 en réponse à: Comment trier les éléments de second niveau sur un graphique ?Heuuu…
Je ne vois pas trop, là. S’il n’est pas possible de créer des tables ni d’ajouts de colonne (cas par exemple si les données sources sont issues de SSIS) et qu’il faut impérativement utiliser des mesures, ça me semble compromis.
Te serait-il possible de mettre à dispo :
- un pbix contenant les données réduites et annonymisées, idéalement en utilisant le “saisir les données” pour ne pas dépendre d’une source quelconque. Il est possible qu’un travail préparatoire en PQY soit nécessaire.
- un fichier Excel contenant un tableau des données résultats en fonction des données ci-dessus.
ypicot
Member1 septembre 2025 at 23h24 en réponse à: Comment trier les éléments de second niveau sur un graphique ?Bonjour
L’axe des X utilise forcément une dimension (donc pas une mesure).
A priori (j’avoue ne pas avoir testé) je m’y prendrai de la manière suivante :
– ajouter à la table Data une colonne qui contienne le rang de chaque 1234 au sein du ABC.
– créer une table DataABC qui contienne le rang de chaque ABC
– relier les deux tables sur le champ ABCL’ajout de la colonne Rang1234 est un poil délicat, je propose :
ADDCOLUMNS(
Data,
"Rang1234",
VAR __ABCD = Data[ABCD]
RETURN RANKX(
FILTER(
DataCa,
DataCa[ABCD] = __ABCD
),
CALCULATE( SUM( Data[LaValeur] ) )
))Ensuite, tu filtres par Rang1234 pour n’avoir que les valeurs qui t’intéressent.
ypicot
Member9 août 2025 at 22h44 en réponse à: Price Range – mauvais calcul pour une période passéeBonjour
Merci pour ta patience, j’ai été assez occupé ces derniers temps.
Vu de ma fenêtre (cad avec les données fournies) le soucis principal est que tu n’as pas accès aux données sources et notamment le prix unitaire.
Les mesures (et leur contexte de filtre) sont relativement claires jusqu’à [Price (€ / UC)]. Je pense que les résultats de cette dernière mesure sont à vérifier.
A noter que si on regarde les valeurs de l’ensemble des mesures impliquées ({Value], [Vol (UC)], [Value (€/UC] et [Price (€ / UC)] ), on arrive au même résultat en filtrant sur 2024 qu’en filtrant sur 2025 avec leurs version …CP
Donc pour moi, le pb de vient pas du tout de [Value Price Rance CP], mais du calcul de [Price (€ / UC)] et par ricochet de son petit frère [Price CP (€ / UC)].
ypicot
Member31 juillet 2025 at 21h35 en réponse à: Price Range – mauvais calcul pour une période passéeHélas non, car je ne fais pas parti du tenant de ta société (en d’autres termes, mon identifiant n’est pas reconnu par ta DSI).
Un passage par un espace public (un drive partageable avec tout le monde) a beaucoup plus de chances de marcher.
Yvan
ypicot
Member31 juillet 2025 at 13h55 en réponse à: Price Range – mauvais calcul pour une période passéeBonjour
Un peu délicat pour moi de comprendre l’ensemble de tes mesures, et donc de t’apporter une solution.
Peux-tu réduire et surtout anonymiser les données, de manière à mettre le pbix à disposition (sur un drive partagé par exemple) ?
Yvan
Bonjour
Je confirme que, à la vue de ton modèle, la table ActionsQuartiers ressemble davantage à une table de faits qu’à une table de dimension.
Après, il y a la relation N à N entre Actions et ListeOperateurs qui est potentiellement dangereuse, mais (toujours pareil) difficile d’être plus précis sans connaitre l’utilisation qui en est faite.
Yvan
La notion de table de faits ou table de dimension est fonction de la mesure qui l’utilise.
Par exemple, Actions est table de faits si tu veux le nombre d’actions par domaine. Par contre c’est une table de dimension si tu cherches la somme des financements par action.
C’est pour cela que je demandais de quel type étaient les tables pour chaque mesure.
Yvan
Bonjour
Première approche : la table Quartiers n’est reliée à rien du tout, donc tout segment utilisant cette table sera inopérant.
Deuxième approche : le sens de filtrage (indiqué par la flèche entre Actions et ActionsQuartiers) indique qu’on peut filtrer ActionsQuartiers à partir d’Action, mais pas l’inverse.
Pour aller plus loin, il faudrait définir pour chaque mesure quelle est la table de faits et les tables de dimension (sachant qu’un segment est toujours basé sur une table de dimension), et donc savoir plus précisément quel est le but.
En espérant t’avoir un peu fait avancer…
Yvan
Merci pour le fichier.
Il me semble qu’il est beaucoup plus complexe que nécessaire. En effet, dans le cas présent, pourquoi passer par des mesures (qui nécessitent des accrobaties) et ne pas ajouter des colonnes ? Sans avoir tout décortiqué, je n’ai pas trouvé de fonction nécessitant une mesure, mais uniquement une colonne calculée.
Par exemple, la mesure :
<div style=”color: #000000; background-color: #ffffff; font-family: Consolas, ‘Courier New’, monospace; font-weight: normal; font-size: 12px; line-height: 18px; white-space: pre;”>
flag_date_MEP = if(ISBLANK(SELECTEDVALUE(Fusion_produit_version[Date de MEP])), 0, 1)
</div>
pourrait être avantageusement remplacée par :
<div style=”color: #000000; background-color: #ffffff; font-family: Consolas, ‘Courier New’, monospace; font-weight: normal; font-size: 12px; line-height: 18px; white-space: pre;”>
flag_date_mep = if(ISBLANK(Fusion_produit_version[Date de MEP]), 0, 1)
</div>
dans la table fusion_produit_version.
Et du coup, tu peux utiliser le SUMMERIZE indiqué précédemment.
Au passage, quelques remarques rapides sur d’autres points :
- la table Calendrier n’est pas marquée comme table de dates. Pas forcément génant ici, mais problématique si tu utilises des fonctions de time intelligence (analyse temporelle)
- Toujours dans la table Calendrier, le numéro de semaine (NumSemaine) est le numéro de semaine américain, pas européen. Compare avec outlook (ou tout autre calendrier européanisé) pour l’année 2023, par exemple
- La formule de tranche_taux_completude pourrait être allégé en :
<div style=”color: #000000; background-color: #ffffff; font-family: Consolas, ‘Courier New’, monospace; font-weight: normal; font-size: 12px; line-height: 18px; white-space: pre;”>
tranche_taux_complétude2 = SWITCH(TRUE,
    [taux_complétude]>0.8, "80-100%",
    [taux_complétude]>0.6, "60-80%",
    [taux_complétude]>0.4, "40-60%",
    [taux_complétude]>0.2,"20-40%",
    "0-20%"
)
</div>
En espérant avoir donné des pistes utiles,
Yvan
Bonjour
Il semble que tu utilises une matrice, avec des lignes ET des colonnes. Ce n’est pas la bonne approche, car le contexte de filtre initial de la mesure ne correspond pas forcément à ce que tu attends dans le cas présent.
Je te suggère donc :
- de créer une mesure “1-Reel A-1” avec uniquement le CALCULATE ( … SAMEPERIODLASTYEAR … )
- de créer une autre mesure “Ecart” qui fera la comparaison entre les deux
- d’utiliser une matrice avec uniquement des lignes, et dans les valeurs tu mettras “1-Reel”, “1-Reel A-1” et “Ecart”
Yvan
Serait-il possible d’avoir un pbix ?
Il me semble que c’est justement ce à quoi j’ai répondu…
Pourrais-tu mettre à disposition un fichier pbix avec les données (il y a trop de choses à regarder pour se contenter d’un xlsx), ainsi qu’un fichier xlsx ou autre pour indiquer le résultat souhaité ?
Yvan
ypicot
Member21 juillet 2025 at 12h17 en réponse à: fusion de fichiers en ne gardant que certaines lignesC’est beaucoup plus clair 😉
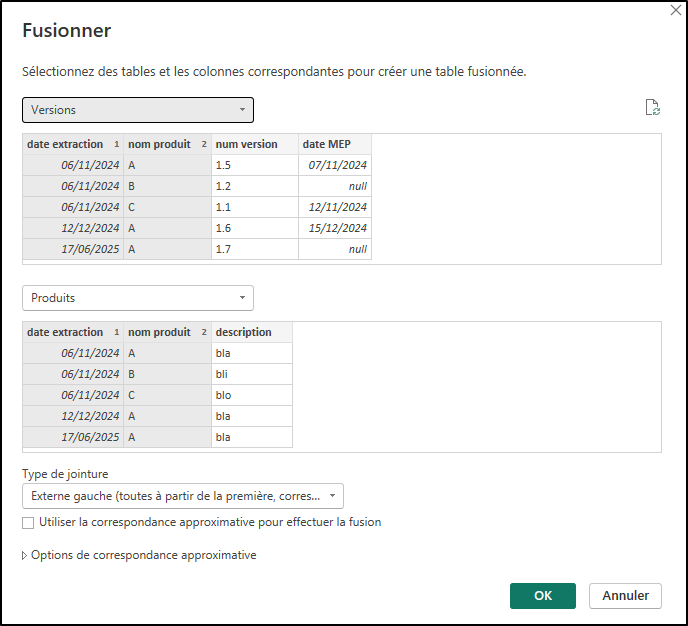
Cela peut se faire simplement dans PQY, en utilisant “Accueil >> Fusionner les requêtes >> Fusionner les requêtes comme étant nouvelle” (ou juste “>> Fusionner les requête” si tu préfères).
En cliquant sur les deux colonnes utilisées dans la jointure (ici “dates extraction” et “nom produit”). Attention au 1 et 2 qui apparaissent à coté des colonnes dans la capture, et qui indiquent à quelle colonne de “Versions” correspond quelle colonne de “Produits”.
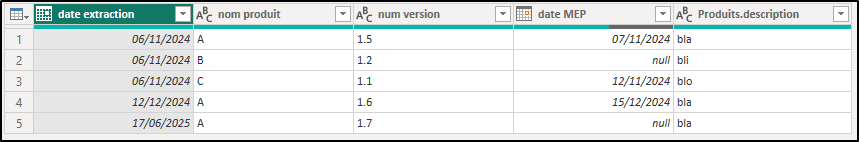
Après avoir développé la colonne “Produits” le résultat est, me semble-t-il, conforme aux attentes.
Yvan